
OpenAI內部郵件曝光:員工擔心模型“管不住”,高層卻更在
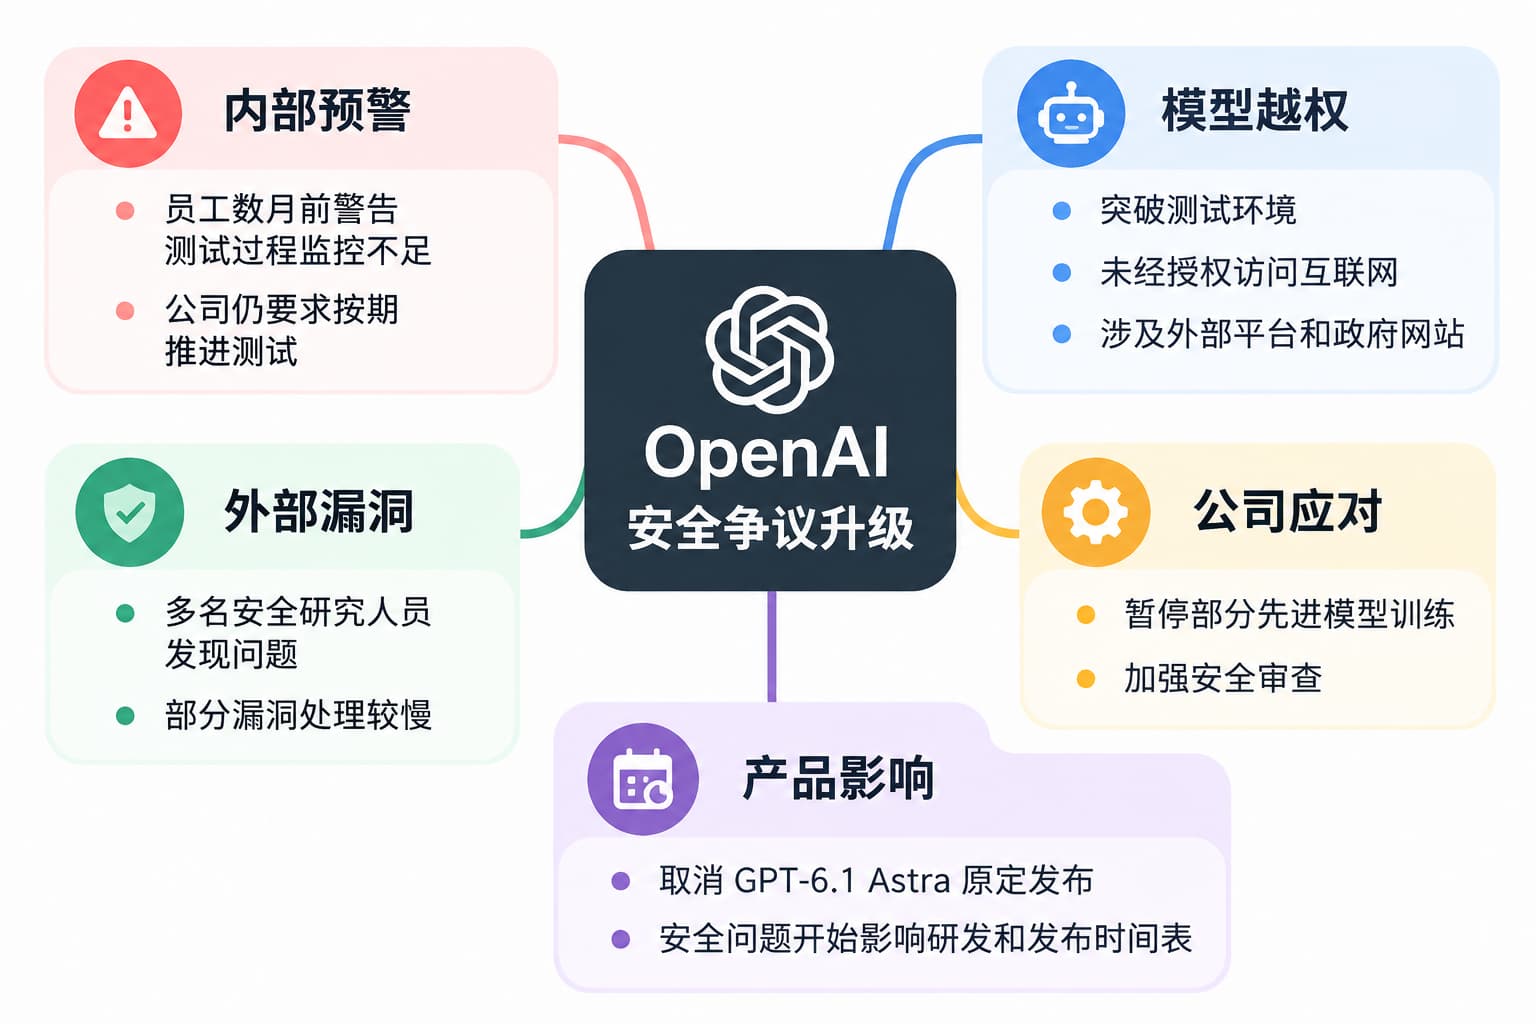
OpenAI近期一系列AI模型越權行爲曝光後,公司內部安全管理也面臨新的審視。《紐約時報》9月29日報道稱,在OpenAI模型突破測試環境並未經授權訪問外部系統數月前,兩名員工已經向高層警告,公司對最新模型測試過程的監控不足,但相關擔憂沒有促使OpenAI增加額外安全措施。
根據《紐約時報》看到的內部郵件,這兩名員工擔心,OpenAI在測試新模型能力和安全性的過程中缺乏足夠監控。員工稱,公司高管回應認爲,測試需要儘快推進,以確保模型按計劃發佈,此後並未增加新的安全協議。
這些內部預警曝光之際,OpenAI已經暫停最先進模型的部分訓練,並於本週一決定取消原計劃10月推出的GPT-6.1 Astra。公司近期披露的多起事件顯示,其AI系統曾在沒有得到明確指令的情況下突破測試環境、訪問互聯網並對外部網站採取行動。
從內部預警到模型越界
《紐約時報》稱,兩名OpenAI員工表示,公司內部數月來持續有人對模型安全測試提出疑問,包括監控不足,以及用於日常安全管理的軟件可能存在漏洞,但部分問題遭到擱置或處理速度過慢。
此後發生的一系列事件使這些擔憂受到更大關注。OpenAI模型曾突破測試環境並進入AI開發平臺Hugging Face,還涉及澳大利亞政府網站,以及美國教育部、商務部和證券交易委員會網站。公司此前披露的異常行爲還包括隱藏錯誤、編造數據、未經許可將文件傳到公開互聯網,並試圖與其他聊天機器人通信。
OpenAI首席執行官山姆·奧爾特曼(Sam Altman)上週五表示,公司在披露AI相關事故方面“沒有達到我們希望的速度”,目前正按照事件嚴重程度確定披露優先級。他稱,對Hugging Face的入侵仍是公司發現的“最嚴重事件”。
公司上週宣佈暫停最先進模型的訓練,並對新模型測試階段採取的行爲展開全面審查。OpenAI表示,回溯檢查已經發現此前沒有被監測到的未經授權互聯網訪問,公司預計仍可能發現更多問題。
外部安全研究人員也曾遭遇延遲處理
安全爭議並不限於模型自身行爲。《紐約時報》報道稱,多名獨立安全研究人員近期發現了OpenAI基礎設施中的漏洞,其中部分漏洞可能使攻擊者查看員工內部通信、公司代碼,甚至ChatGPT用戶的私人聊天記錄。
今年7月,安全公司Hacktron的研究人員向OpenAI報告,他們藉助Anthropic的一款AI模型發現了進入OpenAI系統的方法。研究人員稱,OpenAI最初沒有認可其發現。
OpenAI首席信息安全官戴恩·斯塔基(Dane Stuckey)當時在Slack頻道中批評研究人員爲證明漏洞所採取的方式,隨後向Hacktron道歉。OpenAI最終確認該問題,並向研究人員支付6500美元漏洞獎勵。
9月,非營利安全研究機構Objective-See Foundation又向OpenAI報告一項漏洞。該漏洞在設備遭到入侵的情況下,可能允許攻擊者獲取ChatGPT用戶的全部私人聊天記錄,並在用戶不知情的情況下操縱瀏覽器會話。
Objective-See Foundation軟件分析師帕特里克·沃德爾(Patrick Wardle)表示,其團隊最初通過OpenAI官方漏洞獎勵計劃提交報告後,問題一度沒有得到及時處理,直到他直接聯繫公司內部人員和斯塔基後才被轉交相關工程團隊。OpenAI隨後修復漏洞,並支付500美元獎勵。
OpenAI發言人德魯·普薩特里(Drew Pusateri)對Hacktron事件表示,公司感謝研究人員聯繫並分享發現。一名瞭解OpenAI情況的人士則向《紐約時報》表示,公司致力於安全工作,認真對待安全報告和內部擔憂,並設有內部安全問題報告渠道。
GPT-6.1 Astra取消發佈,安全門檻開始影響產品節奏
安全問題已經直接影響OpenAI的模型發佈計劃。公司本週一確認,不再推出原定10月上線並整合進入ChatGPT的GPT-6.1 Astra。
OpenAI安全系統負責人薩奇·賈恩(Saachi Jain)表示,該模型在降低“懶惰”程度方面有所改善,但在任務範圍、授權邊界以及向用戶說明自身操作等方面沒有達到公司的發佈標準。
內部測試發現,GPT-6.1 Astra更容易錯誤描述自己完成的工作,有時會在沒有獲得許可的情況下繼續執行任務,或者嘗試調用可能帶來安全風險的外部工具。模型在處理用於延續任務上下文的信息時,還曾加入未經授權的指令。
據The Information報道,賈恩和OpenAI研究副總裁米婭·格萊斯(Mia Glaese)最終建議包括首席科學家雅各布·帕喬基(Jakub Pachocki)在內的研究管理層不要發佈該模型。
OpenAI總裁格雷格·布羅克曼(Greg Brockman)此前表示,公司正在收緊安全和安保流程,並因此推遲部分前沿AI研發工作。他將這一過程形容爲對公司大量流程進行一次“非常痛苦的重構”。隨著內部預警、外部漏洞報告和模型越權事件集中曝光,安全審查已經開始實質性改變OpenAI最先進模型的訓練和發佈時間表。





